
Почему Google не индексирует сайт
Бывает, что новый материал уже опубликован, ссылка работает, а через несколько дней его по-прежнему нет в поиске. Иногда проблема действительно находится в настройках сайта. Но нередко с технической стороны всё исправно: поисковый робот получил документ, однако тот пока не вошёл в поисковую базу.
По одному факту отсутствия в выдаче определить причину нельзя. Для начала нужно выяснить, знает ли Google об адресе вообще, пытался ли его открыть и что увидел при последнем обходе. Только после этого имеет смысл проверять robots.txt, директивы для роботов, canonical и сам контент.
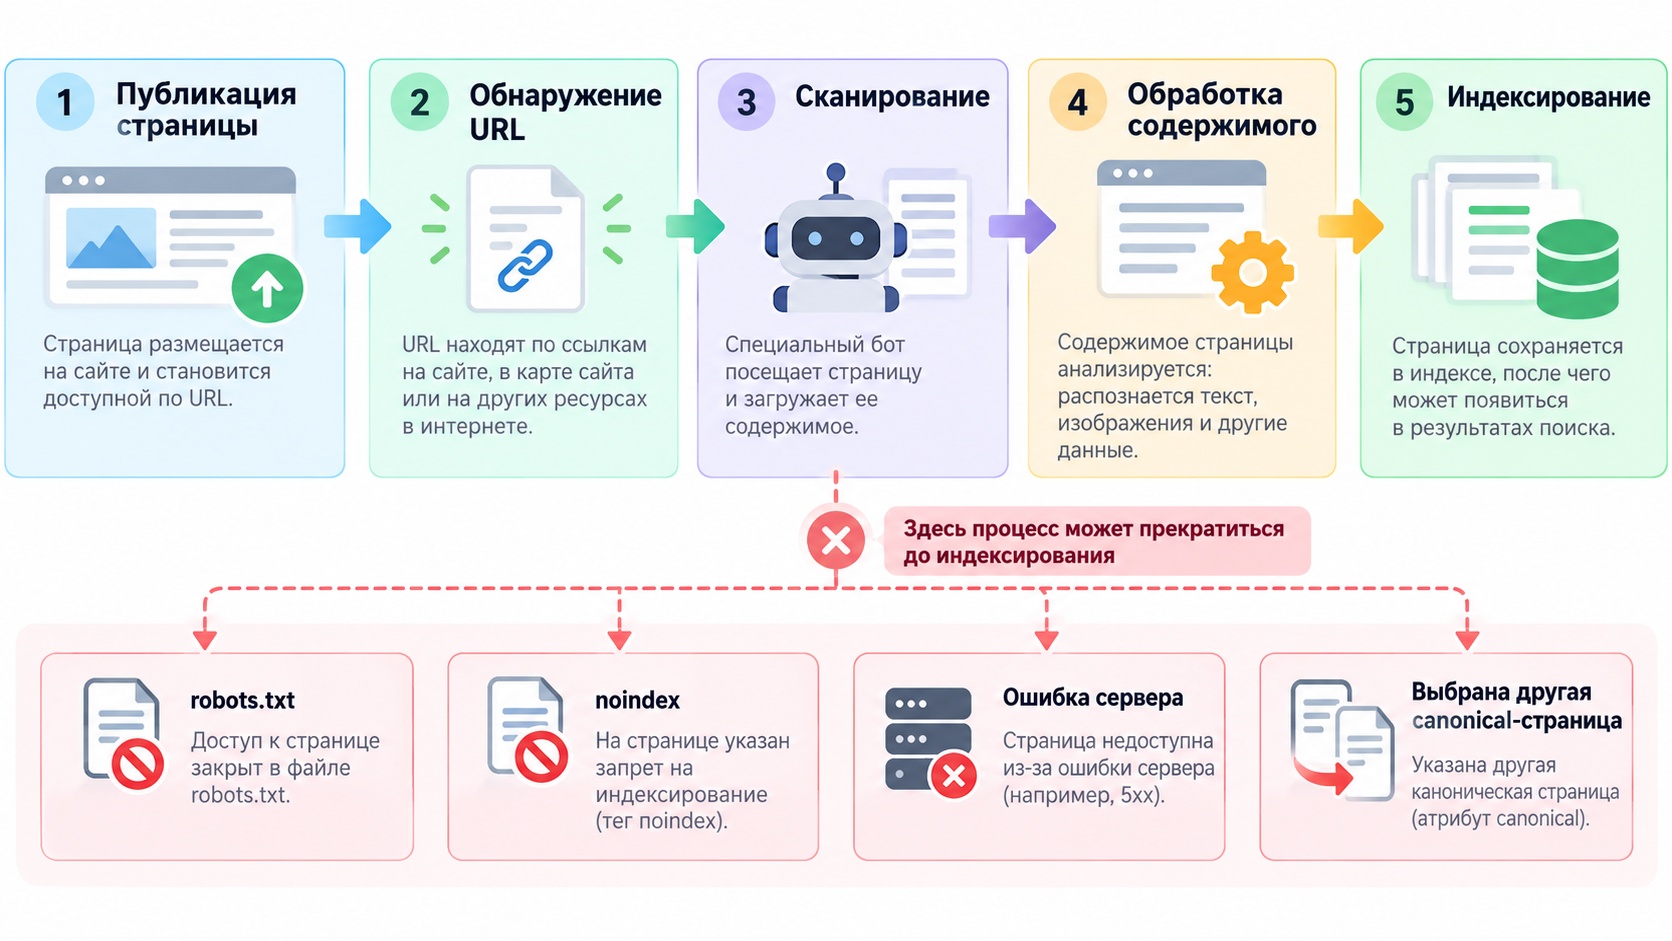
Сначала убедитесь, что проблема действительно в индексации
Самый точный источник для проверки конкретного адреса — инструмент проверки URL в Google Search Console. Он показывает не только наличие документа в поисковой системе, но и информацию о последнем обходе, доступности для робота и выбранной канонической версии.
Запрос с оператором site: тоже может пригодиться, но скорее как быстрая проверка. По нему удобно посмотреть, какие разделы домена вообще появляются в выдаче. Делать вывод о состоянии одного конкретного документа только по такому запросу не стоит.
Есть ещё одно важное различие. Отсутствие по целевому запросу и отсутствие в поисковой базе — не одно и то же. Материал может быть обработан поисковой системой, но находиться далеко за пределами первых страниц выдачи. Поэтому сначала смотрят состояние адреса в Search Console, а уже затем позиции.
Если поисковик пока не нашёл новый адрес
После нажатия кнопки «Опубликовать» поисковой робот не получает автоматическое уведомление от сайта. До нового документа ему ещё нужно добраться. Чаще всего это происходит по ссылкам с уже известных страниц и через XML-карту сайта.
Проблемы начинаются, когда публикация существует сама по себе. Например, статья открывается по прямой ссылке, но её нет в рубрике, на неё не ведёт ни один другой материал, а раздел вообще не связан с основным меню. Для посетителя такой документ почти спрятан. Для поискового робота ситуация похожая.
Поэтому у новой публикации желательно проверить две вещи: входит ли она в нормальную структуру сайта и присутствует ли среди адресов sitemap. При этом сама XML-карта не является приказом добавить всё перечисленное в поиск. Она лишь помогает обнаружить нужные страницы.
На небольшом корпоративном сайте этого обычно достаточно: новая статья попадает в рубрику, с рубрики есть ссылка с главной или другого раздела, а карта сайта обновляется автоматически. Если же свежие материалы остаются изолированными, добавление одного sitemap может не решить проблему.
Что скрывается за статусами Search Console
Формулировки в отчёте иногда выглядят похоже, хотя описывают разные ситуации. Особенно это касается двух распространённых вариантов.
| Статус | Что произошло | Куда смотреть |
|---|---|---|
| Обнаружена, не проиндексирована | Адрес уже известен поисковой системе, но обход ещё не состоялся | Структура сайта, нагрузка на сервер, количество лишних технических адресов |
| Просканирована, но пока не проиндексирована | Содержимое уже получено, однако документ пока не включён в поиск | Дубли, полезность материала, canonical, полнота отрисовки страницы |
У недавно опубликованного материала первый статус сам по себе не выглядит тревожно. Другое дело, если в таком состоянии надолго остаются сотни действительно важных страниц. Тогда нужно искать системную причину.
Почему робот знает адрес, но откладывает обход
На крупных сайтах система управления контентом может создавать намного больше адресов, чем кажется владельцу. Фильтры товаров, сортировки, календарные страницы, параметры, внутренний поиск, различные варианты одного каталога — всё это формирует дополнительные URL.
Если значительная их часть доступна для обхода, робот вынужден разбирать большой массив технических страниц вместе с теми, которые действительно нужны в поиске. Особенно заметна проблема у магазинов и крупных каталогов.
Есть и более прозаичная причина — сервер. Когда он отвечает нестабильно, долго формирует документы или регулярно возвращает ошибки, поисковая система может обходить ресурс осторожнее. При массовой задержке новых материалов поэтому стоит посмотреть не только Search Console, но и журналы сервера.
На маленьком сайте одна статья со статусом «Обнаружена, не проиндексирована» обычно не требует сложного расследования. Если же таким образом завис целый новый раздел, проверять уже нужно структуру и техническую часть проекта.
Когда мешает robots.txt
Ошибка с robots.txt часто появляется после переноса сайта, изменения движка или запуска новой версии. На тестовом домене разработчики закрывают отдельные каталоги от роботов, а после релиза одно из ограничений остаётся в рабочем файле.
Особенно неприятны слишком широкие правила Disallow. Владельцу кажется, что закрыт технический каталог, а под правило попадает и часть полезных материалов.
У robots.txt есть важное ограничение: он управляет обходом, а не служит универсальным инструментом удаления документов из поисковой выдачи. Если поисковику уже известен закрытый адрес, блокировка сканирования сама по себе не всегда даёт тот результат, которого ждёт владелец сайта.
Есть и другая ловушка. Если доступ к документу закрыт через robots.txt, робот не сможет открыть его и прочитать находящуюся внутри директиву noindex. Поэтому использовать одновременно запрет обхода и метатег для удаления одной и той же страницы — плохая схема.
Откуда берётся случайный noindex
На действующем сайте запрет индексирования нередко появляется не вручную, а из настроек CMS или SEO-плагина. Достаточно однажды включить закрытие раздела от поисковиков, а затем забыть вернуть прежнее значение.
Искать такой запрет нужно не только в видимом исходном коде. Он может передаваться разными способами:
- через meta robots в HTML;
- отдельной директивой для Googlebot;
- через HTTP-заголовок
X-Robots-Tag; - через общие настройки движка или SEO-модуля.
Если noindex убрали, мгновенного появления в поиске ждать не стоит. Сначала роботу нужно снова получить обновлённую версию документа. Уже после этого поисковая система сможет пересмотреть его состояние.
Страница работает у человека, но не у робота
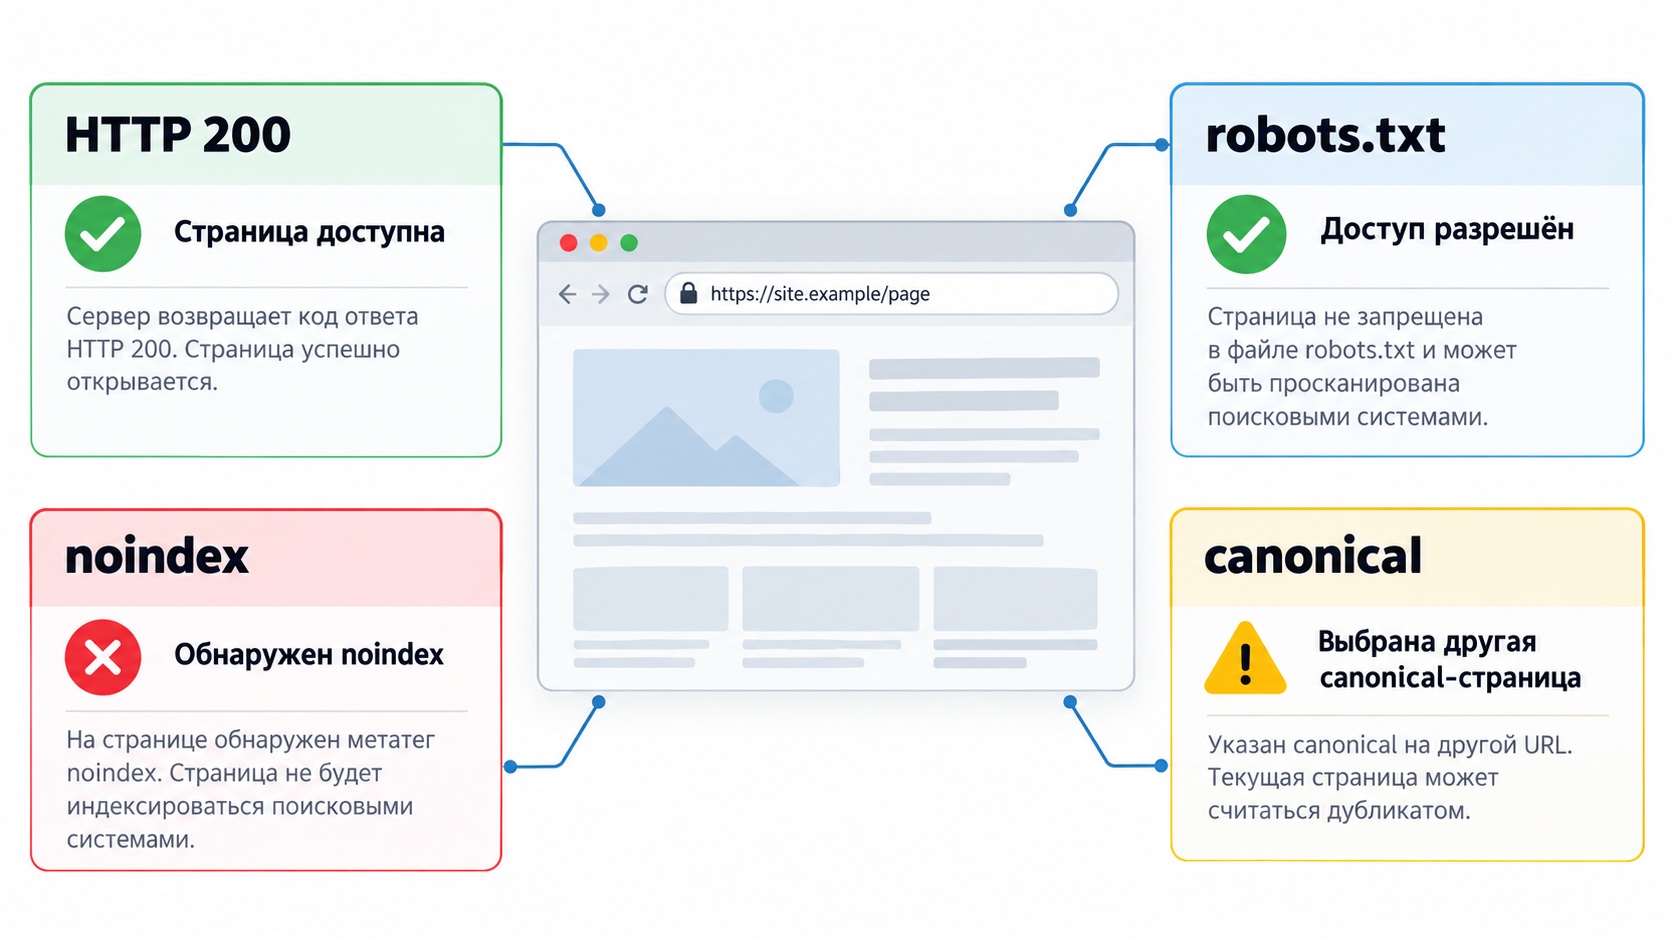
Открыть адрес в браузере недостаточно. Сервер может по-разному отвечать обычному посетителю и поисковому роботу. Защитный модуль, CDN, firewall или ошибочное ограничение способны периодически отдавать Googlebot код 403 или 5xx, хотя у администратора всё выглядит нормально.
Для рабочей публикации ожидается обычный успешный ответ сервера. Ошибки 404, 403, серверные сбои и неудачные цепочки перенаправлений мешают нормальной обработке документа.
Отдельная история — soft 404. Сервер сообщает код 200, но фактически показывает пустую карточку, сообщение об удалённом товаре или страницу почти без содержимого. Технически адрес существует, однако по смыслу напоминает ошибку «ничего не найдено».
Когда Google предпочитает другой адрес
Один материал может быть доступен сразу в нескольких вариантах. Такое встречается у карточек товаров с параметрами, страниц с метками рекламных кампаний, публикаций в нескольких категориях и документов со старыми и новыми вариантами адресов.
В результате поисковой системе приходится определять основную версию. Один из сигналов для этого — rel="canonical", но учитываются и другие признаки: перенаправления, sitemap, внутренние ссылки и сходство содержимого.
Проблема возникает, когда сайт сам посылает противоречивые сигналы. Например, статья указывает canonical на собственный адрес, но все внутренние ссылки ведут на другой его вариант. Или после копирования шаблона в новой публикации остался canonical на старый материал.
Поэтому при подозрении на дубли нужно смотреть не только сам тег. Важнее понять, какой адрес сайт фактически считает основным во всей своей структуре.
Почему после обхода документ всё равно не появляется в поиске
Самая спорная ситуация начинается тогда, когда робот уже получил страницу, но её по-прежнему нет в поисковой базе. В таком случае бессмысленно первым делом снова и снова нажимать кнопку запроса индексирования.
Сначала нужно исключить технические сбои: убедиться, что документ нормально загружается, не закрыт от индексирования, правильно отрисовывается, не указывает canonical на соседнюю страницу и не совпадает почти полностью с другим материалом.
Если здесь всё чисто, стоит посмотреть на содержание без скидок на то, сколько времени ушло на публикацию. Поисковой системе не обязательно хранить каждый URL, который умеет создавать CMS.
Характерный пример — каталог, где сотни карточек отличаются двумя характеристиками и названием. Или страницы одной услуги для разных районов, в которых меняется только география. Формально это отдельные документы, но для поисковой выдачи разница между ними может оказаться слишком небольшой.
Похожая ситуация возникает у пустых тегов, тонких архивов, внутренних результатов поиска и категорий, где кроме пары ссылок почти ничего нет.
Если такой адрес действительно должен привлекать людей из поиска, его нужно рассматривать как самостоятельную страницу, а не как ещё одну запись в базе данных. Она должна отвечать на конкретную потребность: давать характеристики, условия, примеры, сравнения, фотографии или информацию, которой нет на соседних документах.
JavaScript тоже стоит проверить
Современный сайт может собирать значительную часть интерфейса уже после загрузки исходного HTML. Сам по себе JavaScript не является причиной отсутствия в поиске, однако ошибки при отрисовке способны изменить то, что в итоге увидит поисковый робот.
Например, первоначальный HTML почти пуст, а текст статьи, карточки или каталог подгружаются через API. Если нужный запрос не сработал, скрипт завершился ошибкой или часть ресурсов недоступна роботу, итоговая версия окажется неполной.
В такой ситуации полезен тест опубликованного URL в Search Console. Смотреть нужно не только сообщение об успешной загрузке, но и фактически полученную страницу. Если основного контента там нет, исправлять необходимо уже механизм его отдачи.
Sitemap помогает, но ничего не гарантирует
XML-карта особенно полезна на больших сайтах и там, где новые материалы находятся глубоко в структуре. Но она не способна компенсировать противоречивые настройки.
Добавлять адрес в sitemap и одновременно сообщать поисковой системе, что эта страница не нужна, бессмысленно. Типичные конфликты выглядят так:
- документ перечислен в sitemap, но закрыт от индексации;
- canonical ведёт на другой материал;
- внутри сайта почти нет ссылок на этот адрес;
- открывается несколько одинаковых вариантов;
- вместо содержимого робот получает ошибку или пустой шаблон.
Полезная карта сайта обычно содержит канонические рабочие документы, которые действительно должны участвовать в поиске. Автоматическое добавление туда всех адресов, созданных движком, ценности не добавляет.
Если исчезли сразу десятки или сотни страниц
Массовое выпадение — совсем другой случай, чем задержка одной новой публикации. Здесь полезнее начинать не с отдельных документов, а с даты, когда изменилась общая картина.
Стоит вспомнить, что происходило с сайтом примерно в это время. Обновлялся ли шаблон, менялся ли SEO-плагин, был ли переезд на новый сервер, правился ли robots.txt, внедрялись ли новые canonical или редиректы.
Дальше нужно определить, какие именно адреса пропали. Если поисковая система перестала хранить технические фильтры, параметры и дубли, это не обязательно проблема. Если исчезли основные категории, страницы услуг, товары или статьи, искать причину нужно уже как техническую неисправность.
Такой анализ часто быстрее любых массовых правок. Если изменение совпало с конкретным релизом, логичнее проверить его последствия, чем переписывать сотни публикаций, которые ещё неделю назад нормально находились в поиске.
Как действовать без лишних переделок
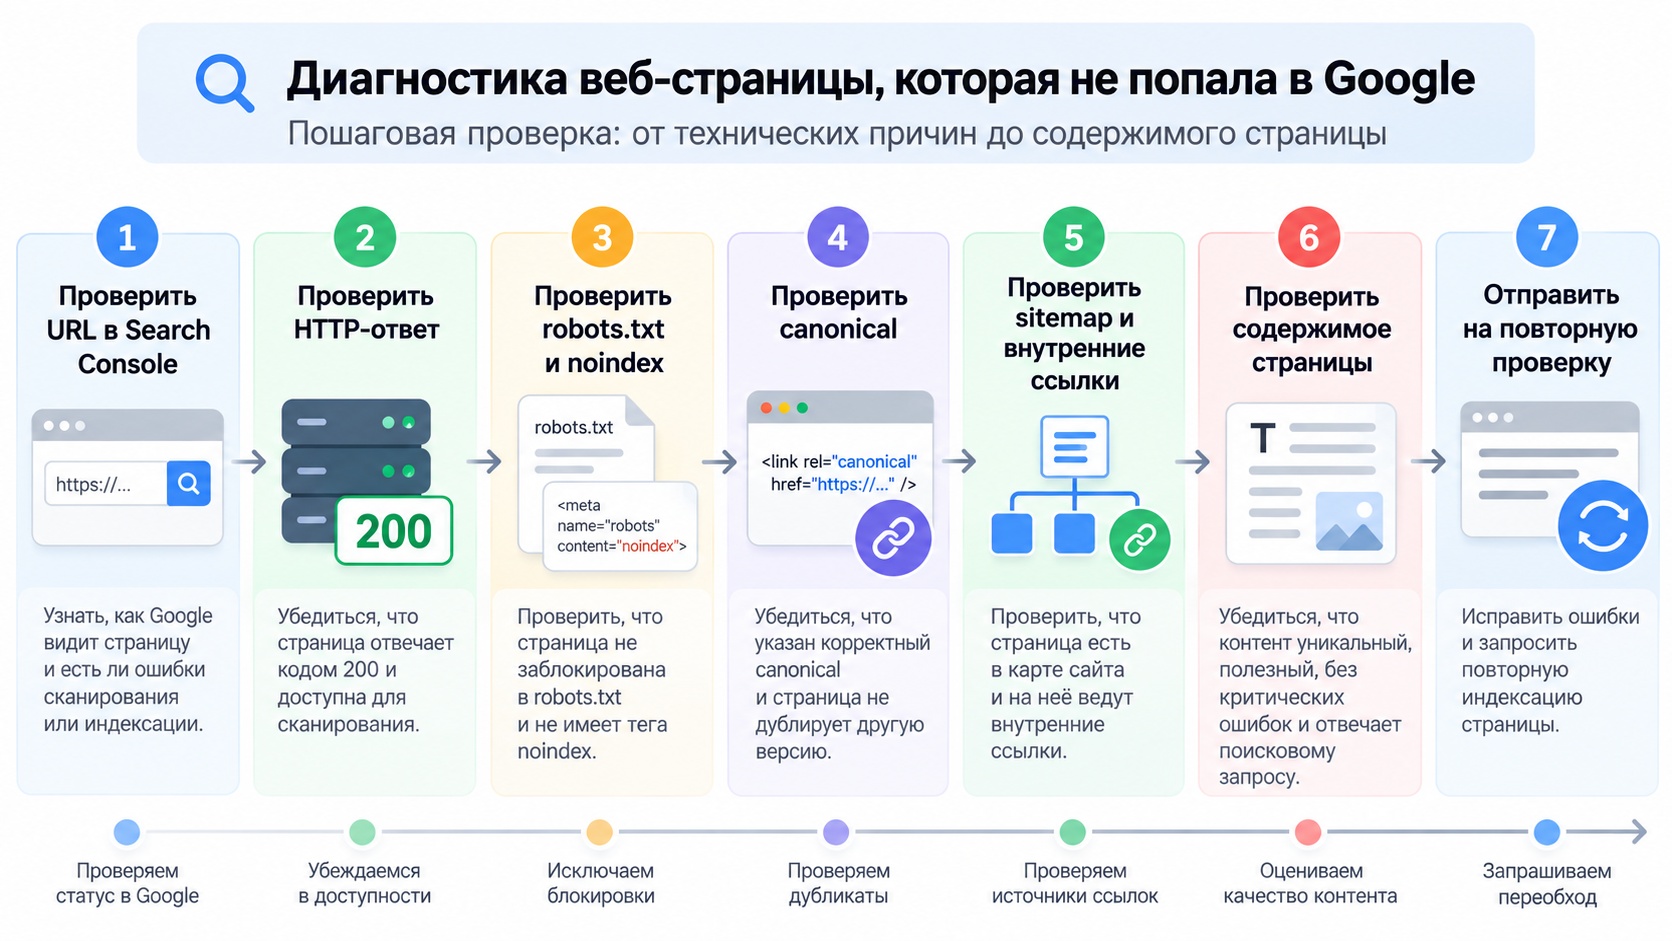
У проблемы с индексированием нет одной кнопки «исправить», но последовательность проверки можно сделать достаточно короткой:
- Открыть нужный адрес в Search Console и посмотреть его текущее состояние.
- Проверить, какой ответ получает поисковый робот и доступно ли ему основное содержимое.
- Просмотреть robots.txt, meta robots и X-Robots-Tag.
- Сверить canonical и возможные копии того же материала.
- Убедиться, что на документ ведут нормальные внутренние ссылки.
- Проверить присутствие канонического адреса в sitemap.
- Если сайт сильно зависит от JavaScript, посмотреть результат отрисовки.
- Только после этого оценивать сам материал и его отличие от соседних страниц.
После исправления найденной причины можно запросить повторную проверку и дождаться следующего обхода. Постоянно отправлять один и тот же адрес заново, ничего на нём не изменив, практического смысла нет.
Не каждая страница обязана находиться в поиске
Большое число исключённых адресов в Search Console выглядит тревожно только без контекста. Практически любой современный сайт создаёт служебные страницы, которые пользователю Google не нужны.
Сюда могут относиться фильтры и сортировки, корзина, авторизация, внутренний поиск, вспомогательные параметры, дубли и некоторые архивы. Для крупного проекта разница между числом существующих и индексируемых URL может быть очень большой.
Поэтому смотреть нужно не на общий счётчик, а на состав исключённых страниц. Если поисковая система не хранит технический мусор, это нормально. Если из поиска выпали документы, на которых должен строиться органический трафик, тогда уже есть повод разбираться.
Почему исправление не видно сразу
После удаления запрета, изменения canonical или устранения серверной ошибки поисковая база не обновляется мгновенно. Робот должен снова прийти по адресу, получить новую версию и передать её на обработку.
Частота обхода у разных сайтов и разделов различается. Популярную категорию робот может посещать регулярно, а новый материал на небольшом ресурсе — заметно реже. Поэтому несколько часов или даже более длительное ожидание после исправления само по себе ещё не говорит, что работа была бесполезной.
Главное — не менять настройки каждый день в надежде случайно попасть в индекс. Намного полезнее один раз установить точную причину: мог ли робот получить документ, не запрещена ли его обработка, какая версия выбрана основной и есть ли у страницы собственный смысл в поиске. После этого становится понятно, что действительно нужно исправлять, а чему просто требуется время.
